Una ciudadana escribe al servicio público: «Me cobraron dos veces, mi usuario está bloqueado y necesito resolverlo hoy». El sistema no necesita empezar redactando una respuesta elegante. Primero debe decidir: ¿es un reclamo de facturación o de acceso?, ¿hay riesgo de fraude?, ¿qué comprobantes faltan?, ¿puede resolver el trámite una regla?, ¿debe escalarlo una persona? Solo entonces conviene pedir a un modelo generativo que explique la solución.
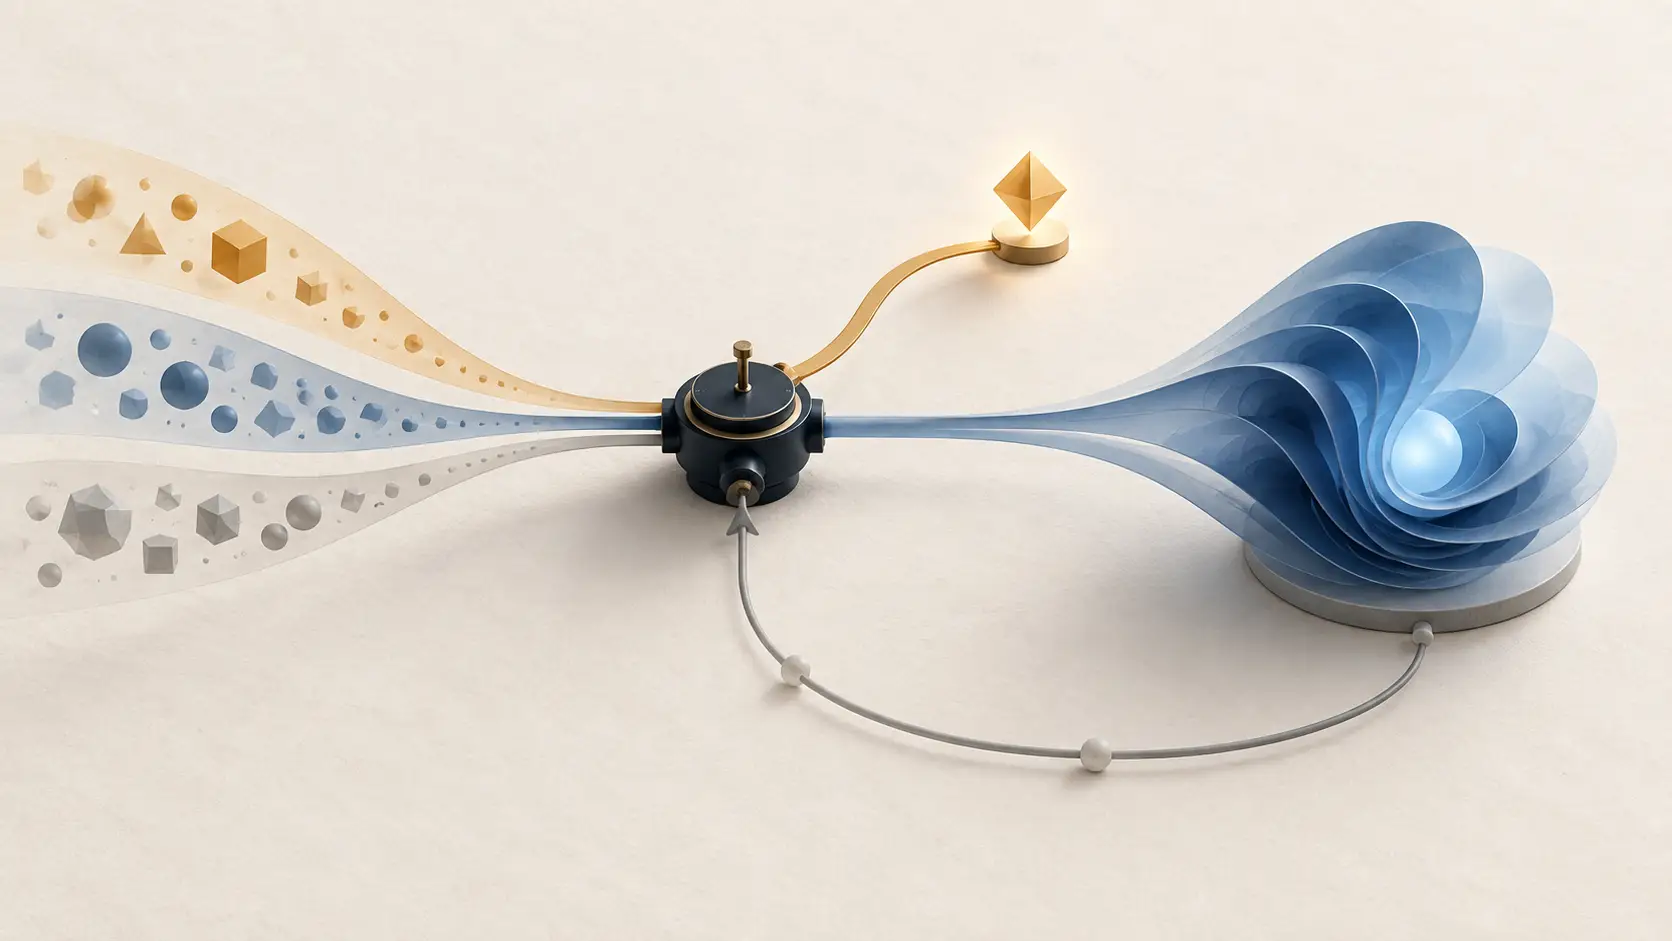
Jev propone separar esos trabajos. La documentación actual de TypeSafe describe un modelo que recibe un estado y preguntas tipadas, y devuelve elecciones, puntuaciones y probabilidades listas para que el software las use. No produce un párrafo para que otro programa lo interprete. La aplicación conserva la lógica y decide cuándo actuar, cuándo pedir más datos y cuándo llamar a un modelo más costoso.
La promesa no es que Jev sustituya a la IA generativa. Es que una capa rápida de juicio coordinará dónde merece la pena generar. La compañía llama RLCD a su entrenamiento orientado a decisiones calibradas: en un sistema bien calibrado, los casos agrupados alrededor del 80% deberían acertar aproximadamente ocho de cada diez veces, no porque una respuesta individual quede garantizada, sino porque la frecuencia observada respalda el umbral. Esa distinción entre probabilidad y confianza operativa aparece en el manual técnico de TypeSafe.
ParallaxSee asigna un 85% de confianza a que, para el 31 de diciembre de 2030, los modelos de decisión serán una pieza estándar de las aplicaciones de IA generativa y Jev habrá ayudado a definir la categoría. Lo verificaremos con tres pruebas simultáneas: Jev o su sucesor documentado deberá mejorar al menos una medida pública de calidad, calibración o eficiencia frente a su línea de 2026; existirán por lo menos tres sistemas independientes con una interfaz de decisión tipada y probabilística; y al menos tres plataformas, marcos o servicios de uso general documentarán en producción una arquitectura que acepte decisiones rutinarias y escale las inciertas a un modelo generativo o a una persona.
La perspectiva panhispánica vuelve el pronóstico más exigente y más útil. España construye infraestructura para modelos en sus lenguas. Chile coordina un modelo regional. Uruguay prueba cómo pasar de la idea al servicio público. Colombia exige seguridad y trazabilidad. México vincula automatización con responsabilidad humana y soporte clínico. En todos esos lugares, el valor no está en que una máquina hable mucho. Está en que tome una decisión limitada, medible y revisable antes de gastar más cómputo o afectar a alguien.
01 — La arquitectura del futuro empieza por admitir que escribir y decidir no son el mismo trabajo.
Un modelo generativo predice una secuencia de palabras. Puede obedecer un formato, devolver JSON y elegir una etiqueta, pero su mecanismo de salida sigue avanzando token a token. El artículo que inauguró el Transformer mostró que la atención permite relacionar posiciones de una secuencia y paralelizar buena parte del entrenamiento; en generación autoregresiva, sin embargo, cada nuevo token depende de los anteriores. Ese diseño está explicado en Attention Is All You Need.
Si la pregunta útil es «¿fraude, error o consulta?», fabricar una frase y volver a analizarla añade superficie de fallo. La alternativa es producir directamente una distribución sobre tres opciones. La aplicación puede aceptar «error» cuando supera un umbral, pedir autenticación si «fraude» conserva probabilidad relevante o remitir el caso si ninguna opción domina. La incertidumbre deja de ser una impresión lingüística y se convierte en una variable del flujo.
La idea de especializar la salida no nació con Jev. BERT demostró que una representación preentrenada podía adaptarse a clasificación y otras tareas mediante capas de salida específicas. Los codificadores posteriores siguieron siendo excelentes cuando las categorías son estables y el entrenamiento está disponible. La novedad comercial de Jev es combinar esa disciplina con preguntas definidas en tiempo de ejecución, varias primitivas y un contrato probabilístico común.
Eso importa para aplicaciones reales. Una aseguradora no quiere que el modelo improvise el nombre de un riesgo; quiere una categoría autorizada. Un hospital no quiere que un clasificador escriba una orden; quiere una señal que active una revisión. Un servicio público no quiere esconder su política dentro de un párrafo variable; quiere reglas que puedan auditarse.
Los modelos de decisión no eliminarán el lenguaje natural. Lo colocarán en el lugar correcto. Un LLM seguirá resumiendo expedientes, explicando opciones y redactando respuestas. La capa de juicio decidirá qué expediente abrir, qué herramienta usar, cuánto riesgo tolerar y cuándo detenerse. En 2030, la aplicación madura no será «un chatbot». Será una composición de modelos, datos, reglas y personas con contratos distintos.
02 — Las primeras pruebas indican una ventaja real, pero también explican por qué no basta con un anuncio.
Una implementación abierta llamada JevLite adaptó Qwen3-4B para observar, en una sola pasada, la probabilidad de etiquetas declaradas. En un banco sintético de detección de estafas telefónicas, el sistema logró una mediana de 64,5 milisegundos por decisión, 4,9 veces menos que el mismo modelo ajustado para generar la respuesta. El estudio Open-Jev informó AUROC de 0,974 y error de calibración de 0,052 en 577 decisiones.
La letra pequeña es esencial. Solo hubo 41 escenarios, todas las llamadas fueron sintéticas y la receta se eligió con exposición al conjunto de prueba. Un ModernBERT entrenado para la tarea no fue significativamente peor. El resultado no prueba una arquitectura universal ni demuestra superioridad en español. Sí aísla un mecanismo plausible: cuando la salida útil es una etiqueta probabilística, omitir la generación puede reducir latencia sin sacrificar la calidad observada.
Otra prueba examinó a Jev como juez de respuestas. El trabajo JEV-as-a-Judge lo comparó con dieciséis jueces generativos y modelos de recompensa. En preferencias ordinarias y factualidad apoyada en evidencia quedó a menos de tres puntos porcentuales del comparador más fuerte usando el 0,36% de su tarifa medida. Una cascada congelada aceptó veredictos confiables y elevó los inciertos; retuvo el 99% de la precisión del juez fuerte con menor coste.
También allí aparecen fronteras. La brecha creció cuando había que verificar una derivación difícil o resistir una respuesta incorrecta redactada con seguridad. Los umbrales no se trasladaron igual entre tareas. Una probabilidad tipada no queda calibrada por decreto.
Estas limitaciones fortalecen la tesis correcta. El modelo rápido no debe fingir que sabe todo. Su valor aparece cuando reconoce un dominio estrecho, ordena los casos por incertidumbre y entrega los difíciles a otra capa. El producto decisivo no será el modelo aislado, sino la política de escalamiento: qué acepta, qué revisa, cuánto cuesta un error y cómo se comprueba después.
03 — La economía favorece cascadas: usar poca inteligencia cuando basta y mucha cuando hace falta.
El principio ya funciona con modelos generativos. FrugalGPT, publicado en Transactions on Machine Learning Research, mostró que cascadas aprendidas podían igualar al mejor modelo individual en las tareas estudiadas con reducciones de coste de hasta el 98%. RouteLLM entrenó routers para elegir entre modelos fuertes y débiles a partir de preferencias, preservando calidad con menos gasto.
Jev lleva esa lógica un paso antes. En vez de preguntar qué generador debe responder, pregunta si hace falta generar. Un reclamo puede resolverse con una elección; un documento, con una puntuación de riesgo; una transacción, con una probabilidad. Solo la excepción consume razonamiento largo o revisión humana.
El reto es medir bien la incertidumbre. La investigación independiente sobre aprendizaje por refuerzo consciente de la calibración redujo hasta nueve puntos el error de calibración esperado en sus experimentos sin perder el nivel de precisión estudiado. No describe el entrenamiento propietario de Jev, pero confirma que exactitud y calibración pueden optimizarse como objetivos separados.
La evidencia más incómoda también ayuda. Just Ask Jev evaluó 44 bancos de fallos de alineamiento. Sus preguntas genéricas alcanzaron una mediana AUROC de 0,886 en los 31 casos aplicables, pero los umbrales absolutos variaron. El modelo podía ordenar bien el riesgo sin que «0,8» significara exactamente lo mismo en cada dominio.
Por eso un despliegue responsable necesita cuatro mediciones. Precisión: cuántas decisiones acierta. Calibración: si las probabilidades coinciden con frecuencias. Cobertura: qué proporción resuelve sin escalar. Coste del error: qué ocurre cuando se equivoca. Un umbral del 90% puede ser razonable para clasificar correo y temerario para negar un beneficio.
La predicción del 85% no supone que Jev ganará todas las comparaciones. Espera algo más estructural: la presión económica hará normal una jerarquía de cómputo. Un modelo barato resolverá lo frecuente; uno potente recibirá lo ambiguo; una persona conservará decisiones irreversibles. Las organizaciones que midan esos traspasos obtendrán velocidad sin comprar una falsa certeza.
04 — América Latina necesita precisamente esa arquitectura porque el cuello de botella no es conversar: es operar.
La guía de implementación de IA en el sector público de la CEPAL organiza los proyectos en tres fases: explorar, desarrollar y operar en un entorno real. Pide comparar la IA con alternativas, definir valor público, probar, monitorear y rendir cuentas. Es una descripción casi perfecta del espacio donde una decisión tipada supera a una demostración vistosa.
Uruguay ya utilizó esa metodología con desafíos de instituciones reales. El taller documentado por la CEPAL reunió organismos públicos para llevar problemas desde la identificación hasta el diseño de soluciones. El salto difícil no consiste en producir una respuesta impresionante durante una presentación. Consiste en integrar datos, responsables, excepciones y controles dentro de un servicio que funcione el lunes siguiente.
La escala regional vuelve urgente la eficiencia. El ILIA 2025 de CEPAL y CENIA, publicado en 2026, observa 19 ecosistemas nacionales y separa factores habilitantes, investigación, adopción y gobernanza. La región adopta aplicaciones generativas con rapidez, pero las capacidades de infraestructura, talento e inversión siguen distribuidas de manera desigual. Cada llamada innecesaria a un modelo grande amplifica esa diferencia.
Una capa de decisión ofrece tres ventajas. Reduce cómputo en casos rutinarios. Permite ejecutar modelos más pequeños cerca de los datos. Y traduce objetivos administrativos en variables comprobables: urgencia, elegibilidad, anomalía, prioridad. Eso no resuelve por sí solo la falta de calidad de datos ni la fragmentación institucional, pero hace visible dónde falla el proceso.
También evita copiar el chatbot como forma universal. Una municipalidad puede necesitar clasificar solicitudes, no conversar. Una aduana puede necesitar puntuar riesgo, no escribir. Una empresa eléctrica puede necesitar detectar anomalías y escalar. La interfaz debe seguir el problema.
El mundo panhispánico no es un único mercado técnico. Cambian leyes, vocabularios, formularios y tolerancias al riesgo. La categoría tendrá éxito si permite compartir el patrón —decidir, medir, escalar— sin imponer las mismas etiquetas ni umbrales a todos los países.
05 — El español no es una traducción del sistema: es parte del sistema que decide.
Latam-GPT muestra la magnitud del trabajo. CENIA presentó en 2026 un modelo regional abierto, construido con más de 60 instituciones de 15 países y un corpus pensado para variantes, historias y contextos latinoamericanos. La descripción oficial de Latam-GPT estima que el español representa cerca del 4% de datos en repositorios abiertos usados habitualmente para entrenar modelos. Hablar español no garantiza entender una institución.
La evaluación debe ser igual de local. Los bancos Trueque y Choclo prueban conocimiento, cultura y lenguaje latinoamericanos. Su pregunta implícita es decisiva: ¿a quién responde el modelo cuando interpreta «palta», «aguacate», «desaparecidos» o una entidad pública cuyo nombre solo existe en un país?
España construye otro tramo de la infraestructura. El convenio publicado en el Boletín Oficial del Estado para tecnologías del lenguaje reúne ministerios, AESIA, Instituto Cervantes, Barcelona Supercomputing Center, RAE, ASALE y universidades. Prevé modelos en español y lenguas cooficiales, corpus iberoamericanos, marcos de evaluación y colaboración con instituciones públicas de la región.
Los modelos de decisión pueden aprovechar esa base mejor que una interfaz monolingüe. Una pregunta tipada puede conservar la misma semántica y ajustar ejemplos, datos y umbrales por jurisdicción. «Prioridad alta» debe significar algo verificable en Bogotá, Montevideo y Madrid, aunque los documentos que la activan sean distintos.
Aquí aparece una ventaja positiva: especializar no exige aislar. Un modelo regional puede proporcionar representaciones lingüísticas; una capa de decisión puede convertirlas en opciones; el código local puede aplicar la norma; una persona puede revisar la excepción. Cada nivel mejora sin pretender sustituir a los demás.
La señal alcista hacia 2030 será que los bancos panhispánicos dejen de evaluar solo respuestas largas y midan también calibración, abstención y coste de escalamiento. Si una probabilidad se usa para actuar, debe comprobarse en el idioma, el país y la población afectados. La soberanía tecnológica empieza cuando la región puede medir no solo qué dice un modelo, sino cuándo merece confianza.
06 — España anticipa la regla de oro: una decisión pequeña debe dejar una huella grande.
La Agencia Española de Protección de Datos mantiene un catálogo específico sobre IA y decisiones automatizadas. En su área de innovación y tecnología reúne guías de exactitud, idoneidad, calidad de datos, auditoría, intervención humana y gestión de riesgo. La enseñanza práctica es que el componente probabilístico no puede separarse del tratamiento completo.
La propia AEPD explica que un sistema de IA no es un algoritmo solitario. Incluye interfaces, comunicaciones, modelos, reglas y personas; todos deben evaluarse según su impacto. Su nota «Sistema de Inteligencia Artificial: ¿solo un algoritmo o varios algoritmos?» insiste en transparencia, explicabilidad e intervención humana.
Esa visión favorece una arquitectura por capas. Si el sistema devuelve únicamente un texto persuasivo, reconstruir la decisión puede resultar difícil. Si devuelve una opción, una distribución y un identificador de política, se puede registrar qué versión operó, qué umbral se aplicó, qué dato faltó y por qué el caso escaló.
Pero la estructura tampoco garantiza justicia. Una categoría puede estar mal definida. Un conjunto histórico puede reproducir discriminación. Un umbral puede maximizar eficiencia a costa de quienes reclaman en una variante lingüística minoritaria. La trazabilidad solo sirve si una organización la usa para corregir.
El estándar de 2030 será más que JSON válido. Incluirá fichas de modelo, evaluación por subgrupos, registro de cambios, pruebas de deriva y rutas claras de objeción. En decisiones relevantes, el usuario deberá saber que intervino un sistema y encontrar una persona capaz de revisar el resultado con autoridad real.
Jev puede prosperar si convierte su confianza en un instrumento de gobernanza. Si se limita a ser «más rápido», un codificador específico o una función del próximo LLM absorberá la ventaja. Si hace fácil probar, registrar y escalar, la interfaz se volverá valiosa incluso cuando el modelo subyacente cambie. España ofrece el criterio: no basta con acertar; hay que poder demostrar cómo se controló el riesgo.
07 — Colombia convierte el pronóstico en un problema nacional de diseño, seguridad y soberanía.
La Política Nacional de Inteligencia Artificial de Colombia, CONPES 4144, aprobada en 2025, articula ética y gobernanza, datos e infraestructura, investigación, talento, mitigación de riesgos y adopción. No pide una máquina universal. Pide capacidades que conecten la tecnología con objetivos públicos y productivos.
En 2026, MinTIC publicó lineamientos de seguridad y privacidad para sistemas de IA. Incluyen monitoreo continuo, análisis de anomalías, pruebas de robustez y gestión de riesgos durante diseño, desarrollo, implementación, operación y mantenimiento. Esa secuencia coincide con lo que un modelo de decisión necesita para entrar en producción.
Pensemos en un trámite. Un modelo clasifica el asunto, otro detecta datos sensibles, una regla consulta competencia territorial y un generador prepara un borrador. La respuesta final pasa a una persona si la confianza baja, la consecuencia es alta o las señales se contradicen. Ningún componente merece toda la confianza; el sistema completo distribuye responsabilidad.
Colombia añade una razón regional para preferir salidas estrechas. Los datos públicos y empresariales pueden ser valiosos sin salir de la jurisdicción ni convertirse en prompts extensos enviados a un servicio remoto. Un modelo pequeño puede puntuar localmente y compartir solo el caso que exige capacidad superior. No siempre será posible, pero la arquitectura abre esa opción.
La seguridad también mejora cuando el permiso depende de categorías declaradas. Un agente generativo con acceso amplio puede interpretar una instrucción maliciosa y ejecutar demasiado. Una capa de decisión puede limitar estados y acciones: consultar, solicitar documento, bloquear temporalmente, escalar. Sigue siendo vulnerable a datos falsos y ataques, pero reduce el repertorio disponible.
El indicador alcista será que políticas como la colombiana produzcan componentes reutilizables: evaluadores, registros, umbrales y rutas de supervisión compartidos entre instituciones. El bajista será acumular pilotos sin responsables operativos. Jev no resolverá esa gobernanza; puede darle una forma técnica que las entidades sepan medir.
08 — México muestra dónde termina la automatización y empieza la responsabilidad humana.
La declaración presentada por Secihti y la Agencia de Transformación Digital y Telecomunicaciones sostiene que toda decisión apoyada por IA debe tener responsables humanos y que una decisión inexplicable no debe automatizarse. La declaración mexicana de ética y buenas prácticas también vincula la tecnología con diversidad cultural y lingüística, bienestar, participación y soberanía.
No es una prohibición de decidir con modelos. Es una invitación a definir el límite. Clasificar la materia de un escrito puede automatizarse con revisión estadística. Negar una prestación, imponer una sanción o descartar un diagnóstico requiere garantías mayores. La consecuencia, no el brillo técnico, determina el nivel de supervisión.
Salud ofrece el ejemplo más claro. La Secretaría de Salud mexicana enumera análisis predictivo, inventarios, asistentes y diagnóstico entre las aplicaciones posibles, y su área de tecnologías sanitarias trabaja con sistemas de soporte para decisión clínica. La página oficial sobre IA para la toma de decisiones en salud presenta la tecnología como ayuda para planificación y gestión, no como sustituto automático de profesionales.
Un modelo de decisión podría priorizar expedientes, detectar una combinación de síntomas que merece revisión o anticipar demanda de insumos. La salida útil sería una probabilidad acompañada de datos relevantes y un protocolo. La explicación clínica y la determinación final pertenecerían a otra capa.
Ese reparto es más honesto que pedir a un chatbot que parezca médico, jurista y funcionario a la vez. También es más exigente: obliga a decidir qué pregunta puede responder el modelo, con qué evidencia, para quién y qué ocurre después.
México será un laboratorio decisivo por su tamaño, diversidad lingüística, sistema federal y demanda de servicios. Si las interfaces tipadas permiten adaptar categorías sin reconstruir cada modelo desde cero, ganarán terreno. Si ignoran lenguas, territorios o derecho de revisión, multiplicarán la exclusión con mayor velocidad. El futuro favorable no es automatizar más decisiones. Es automatizar las adecuadas y hacer visible quién responde por ellas.
09 — En 2030 no preguntaremos si Jev fue famoso: contaremos mejoras, competidores y despliegues verificables.
La resolución positiva exige tres condiciones antes de las 23:59 UTC del 31 de diciembre de 2030. Primera: Jev, o un sucesor que TypeSafe identifique de manera documentada, mejora frente a la línea pública de 2026 en por lo menos una medida comparable de calidad, calibración o eficiencia, con método y conjunto de evaluación disponibles. Una versión nueva sin evidencia no cuenta.
Segunda: existen al menos tres sistemas independientes de Jev que aceptan contexto y preguntas tipadas, y devuelven decisiones más probabilidades sin necesitar una respuesta generativa como interfaz primaria. Pueden ser servicios alojados, modelos abiertos, codificadores adaptables o funciones de plataformas mayores. No deben compartir el mismo proveedor ni limitarse a réplicas abandonadas.
Tercera: al menos tres plataformas, marcos o servicios de uso general publican documentación de producción para una cascada que acepta decisiones rutinarias y escala las inciertas a un generador más potente o a una persona. Cada caso deberá describir al menos un umbral, criterio de abstención o regla equivalente. Tres demostraciones del mismo fabricante no cuentan como tres adopciones.
El pronóstico será falso si falta cualquiera de las condiciones. Jev puede desaparecer y aun influir intelectualmente, pero eso no satisface la primera prueba. Los LLM pueden devolver JSON más rápido y absorber la categoría, pero si no existen alternativas independientes ni despliegues documentados, tampoco basta. Y una multitud de clasificadores tradicionales no cuenta si carece de preguntas flexibles y salidas probabilísticas consumibles por software.
Hay razones para el 15% de duda. Los modelos generativos pueden abaratarse tanto que el ahorro pierda importancia. Los codificadores específicos pueden dominar las tareas estables. La calibración puede degradarse entre países y dominios. Empresas y gobiernos pueden preferir una sola API aunque sea menos eficiente. TypeSafe puede no sostener el producto. La opacidad de un número sin evidencia puede provocar rechazo regulatorio.
Las señales alcistas serán comparaciones reproducibles en español, umbrales que sobrevivan cambios de dominio, integración con Latam-GPT y ALIA, y servicios públicos que publiquen cobertura, error y tasa de escalamiento. Las bajistas serán demos sin datos, probabilidades decorativas y políticas que no concedan revisión humana.
Nuestra respuesta sigue siendo sí. Para 2030, la IA útil se parecerá menos a un oráculo y más a una organización bien diseñada: una capa recibe el caso, otra decide lo rutinario, una tercera razona sobre la excepción y una persona conserva autoridad sobre lo irreversible. Jev no necesita escribir el futuro. Le basta con haber enseñado al software a decidir cuándo debe escribir.